AI省钱利器 | OPC专文 AI省钱利器!医疗小团队Token实操 |
独立诊所的医生、医学研究者、医疗 AI 小团队,这几个月都被同一件事扎到:Token 账单涨了。大模型越贵,越要想办法省着用——这句话放在 2026 年下半年格外真实。9 月 1 日,DeepSeek 新版 API 的峰谷分时计价正式生效:V4-Pro 旗舰模型高峰时段输出价格达 27 元 / 百万 Token,周末低谷为 13.5 元 / 百万 Token,而调价前统一定价仅 6 元 / 百万 Token,即便选低谷价,绝对成本也比涨价前涨了约一倍。摩根士丹利研报也显示,中国大模型平均 API 输出价格一年多来回升约八成。对大型医院,账单是财务报表上的一行;对独立诊所医生、医学研究者、医疗技术个人和小型医学 AI 团队这类"一人公司",每一次调用都是自己口袋里的真金白银——模型一贵,很多人第一反应是"少用了",但少用了也就少接了单、少赚了钱,等于被涨价反向收割。
这恰恰反了。越是模型贵,越该把"输入侧"看清楚。行业里有个反直觉的事实:很多医学团队和小团队的 Token 浪费,不在模型贵,而在提问太脏——把整份病程记录、整段影像报告、整库随访条文原样塞进提示词,模型大量算力花在重复上下文上;为了"多出几版方案"反复调用,产出却没人看;同一份指南被不同项目各问一遍,缓存完全没复用。研究普遍指向一个区间:AI 推理开销里,有三到五成属于可压缩的浪费。对个人和医学小团队,这个比例只会更高,因为没人专门做提示词治理。
更现实的背景是政策在给"一人公司"松绑。江苏省 2026 年发布《关于支持人工智能一人公司发展的若干措施》(苏发改智集发〔2026〕580号),明确对 AI 一人公司、不超过十人的 AI 创业团队给予算力券、语料券、模型券、Token 券等专项扶持,并配套信贷支持。这意味着,国家层面认可"一个人也能靠 AI 干成一摊事",并且愿意在成本上托一把。但券是补贴,不是免死金牌——会压请求侧的人,把券花在刀刃上;不会压的人,券发下来照样被浪费掉。会省和不会省,拿到同样的扶持,结局天差地别。对医学研究者、独立医生这类靠专业吃饭的个人,这条政策尤其值得留意。
具体到医疗场景,小团队踩的坑有三类。第一类是"病历与文书写作":写病程记录、出院小结、质控报告,提示词里反复粘贴整套模板和既往病历,单次调用上千 Token,一个科室一个月下来量很可观,而且顺手就把患者姓名、病历号送了出去。第二类是"影像与文献分析":把影像所见、大段指南、论文整库投喂求归纳,上下文又长又重复,还容易把尚未脱敏的病例信息带进公开模型。第三类是"随访与数据处理":随访表、检验明细成批投喂,长文档吃 Token,却从没想过先做一遍精简。三类人的共同点:调用频繁、单次价值高、提示词又脏又长,钱就这么悄悄流走,风险也顺着数据一起溜了出去。
这类团队往往请不起专职 IT,也搭不起企业级网关,更不敢把患者病历和影像资料往公开模型里送。他们要的不是一套复杂的治理平台,而是一个"装在自己电脑上、请求侧先压完再送出"的轻量工具——既把 Token 省下来,又把敏感数据拦在本地。这恰是单机版压缩网关的价值所在:不用改工作流程,打开就能用,压完再问。对一人公司和小团队,轻量比完整重要,能上手比能汇报重要。
对应的,也有三类已经跑通的做法。有临床医生把常用诊疗规范、病历模板做成一次性精简索引,每次只带相关片段进提示词,单份文书的 Token 直接砍掉一大半;有医学研究者用本地工具先把病例数据脱敏再分析,既守住数据合规,又避免把患者信息送出去;有医疗 AI 小团队把重复的文献归纳需求做成可复用模板,同类问题走缓存不再重复烧 Token。他们没换更便宜的模型,只是把"进模型的请求"管住了——省下的,就是实打实的预算。
怎么判断自己有没有在浪费?给医学小团队三个能自查的数。第一个数,看单次提示词长度:如果一次调用带进去的上下文经常超过两千字,而真正被模型用上的只有几百字,中间的差额就是白烧的钱。第二个数,看重复率:同一份病历模板、同一张影像报告结构,一个月里被粘贴进提示词多少次?重复十次以上的内容,就该做成精简索引而不是每次原样投喂。第三个数,看废稿率:生成的病历、报告里有多少根本没归档?如果超过一半,说明问题不在模型不够聪明,而在需求没说清就急着调用。三个数一算,浪费在哪儿基本就浮出来了。
选工具也有三条标准,别被花哨功能带跑。第一条,压缩必须发生在请求侧且保真——只精简你写给模型的提示词,不动模型的输出,语义留住、效果不打折。第二条,数据必须留在本地——病历、影像、患者标识这类东西,脱敏和压缩都应该在自己电脑上完成,不该先送到别人的服务器再处理。第三条,必须即装即用——一人公司没有运维,任何需要部署、配置、写代码的方案都会被现实劝退,打开就能压、压完就能问才是能坚持下来的方案。三条都满足,工具才可能真的融进日常。
还有一层很多人没意识到:压缩和脱敏是一件事的两面。你把提示词精简了,顺手也就把里面多余的 patient 信息、项目标识剔掉了——输入侧越干净,既省钱又合规,两个目标一次达成。对医学个人和小团队,这比单独买一套合规系统现实得多:一台 Windows 电脑、一个本地工具,请求侧压完再送出,敏感数据不出本地,Token 也省了。
这里必须讲清一个边界:压缩发生在请求进入模型之前,只作用于你写给模型的提示词与上下文,绝不涉及模型返回的内容。模型怎么回答、回答得好不好,原样透传,不被任何压缩改动。我们做的,是"提问"这一侧的工程精简——去冗余、合并重复、压长上下文,把语义留住、把 Token 砍掉,效果不打折。
{AIZIP_CARD}对个人和医疗小团队,省钱的正确姿势可以总结成四步。第一步,收口入口:别再散用个人账号调各家模型,用一个聚合网关把常用模型收到一起,先看见自己的 Token 流向。第二步,压输入侧:借助 51AIZip 这类单机版工具,在请求进模型前做自研保真压缩,把长上下文、重复片段先精简,压缩比通常能到三到七成,语义不丢、效果不打折。第三步,脱敏再问:患者姓名、病历号、影像标识先脱敏再进模型,既守数据合规,也防止病例信息外泄。第四步,复用缓存:同类问题做成模板走缓存,别每次都从头烧 Token。软件下载地址 https://51aipro.com/aizip/ ,Windows 即装即用,数据不出本地。
把这四步做成日常习惯,省下的不是一次两次的钱,而是每个月都有的稳定盈余。模型越贵,这个习惯越值钱——别人因为涨价被迫少接单,你因为会压反而能多接。对靠 AI 提效的医生、医学研究者和医疗小团队,这差距一年下来就是实打实的收入差距。而如果你所在的单位已经在铺 AI 场景、各科室在批量用模型,那企业侧的答案是 51Tokens 企业级 AI 治理管控平台——统一网关、分级预算、敏感识别、全量审计一套做齐,把全医院的 Token 账单和合规风险一起管住。个人用 51AIZip 把顶级大模型用得起,企业用 51Tokens 把 AI 用得安心,两端合力才是完整解法。省,从来不是少做,是把每一分 Token 花在产出上。你现在的 AI 调用里,有没有算过"有效 Token"占比?欢迎在评论区聊聊你的压缩经验。
图:51AIPro 全流程 AI 治理一体化解决方案 · 服务架构
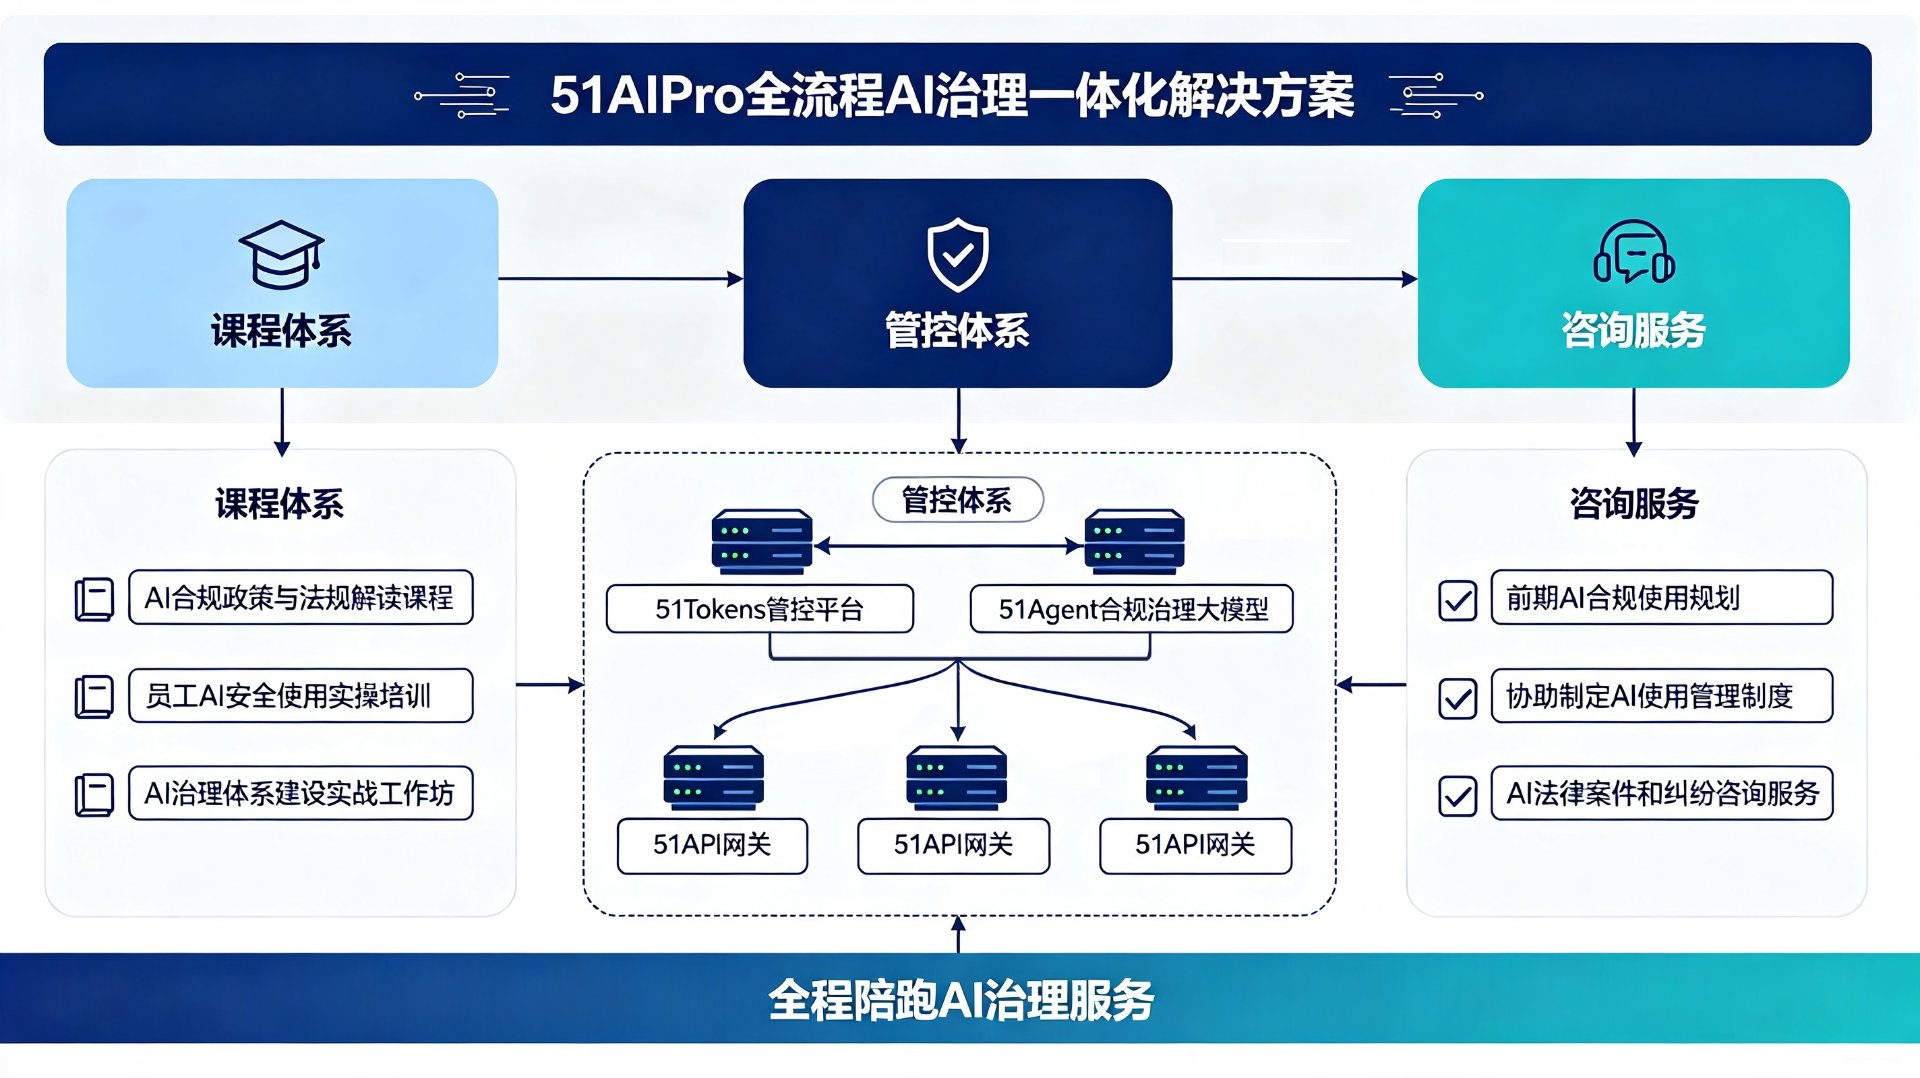
—— 51Tokens,让每一次模型调用都看得见、说得清、查得到
51AIPro · 企业AI治理专家
安全·合规·可控·增效,AI 全流程治理一次布防
 长按识别 · 关注公众号 |  长按识别 · 合作洽谈 |
官网 https://51aipro.com/